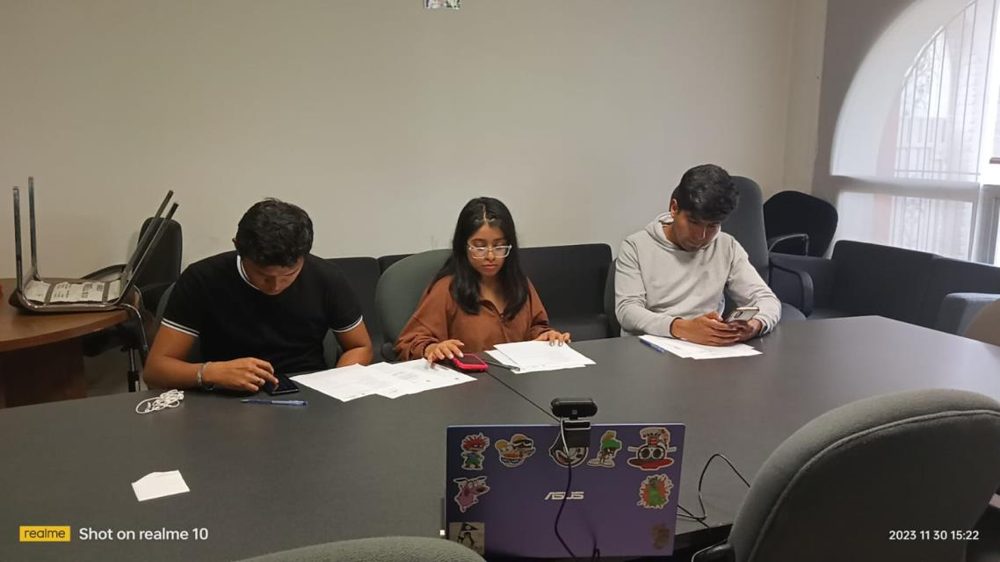
Nota sobre el equipo: este estudio se realizó en equipo de tres investigadoras. Mi rol fue el de moderadora: recibir a los participantes, explicar la dinámica, gestionar el consentimiento informado y conducir cada sesión. Mis compañeras Luz Marisol Falfán y Nayely Valadez fungieron como observadoras.
El contexto
inDrive funciona con un modelo distinto al de sus competidores: el pasajero propone una tarifa y el conductor la acepta o contraoferta, hasta llegar a un acuerdo. En Xalapa, Veracruz, es la única aplicación de este tipo con uso extendido, lo que la vuelve un caso interesante — su usabilidad afecta directamente la movilidad de la ciudad.
El diseño del estudio
Definimos un protocolo de 14 tareas que cubría el recorrido completo de un usuario nuevo, desde instalar la app hasta cancelar un viaje:
- Entrar a la Play Store e instalar
- Activar la ubicación en el dispositivo
- Abrir la aplicación y registrarse
- Solicitar traslado: destino, tarifa ($45.00) y método de pago
- Buscar conductor y cancelar
Los participantes se organizaron en tres grupos con perfiles distintos, incluyendo estudiantes de tecnologías computacionales y usuarios sin experiencia previa con la app. Se midió porcentaje de completitud y tiempo promedio por tarea.
Tres instrumentos, tres ángulos
- Desempeño — completitud y tiempo por tarea, medidos en sesión.
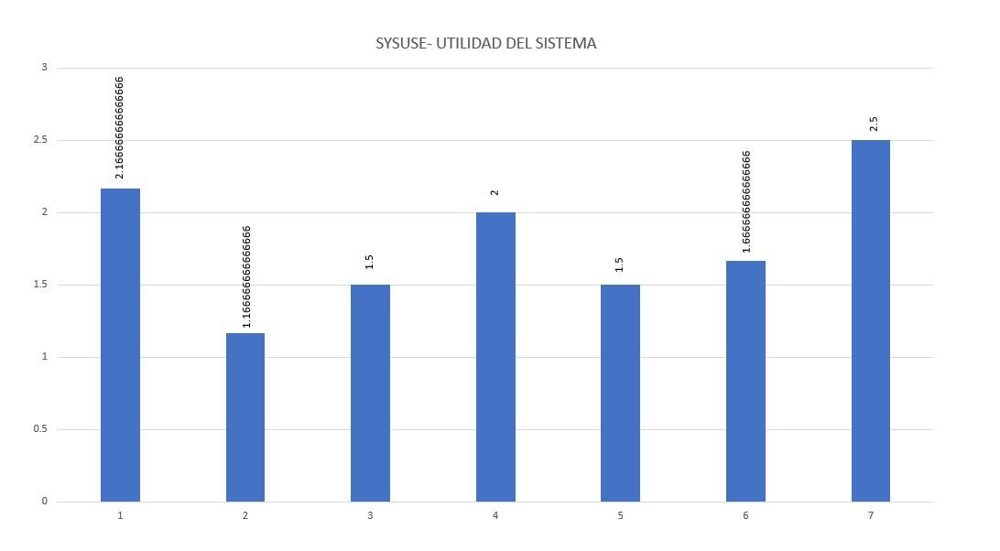
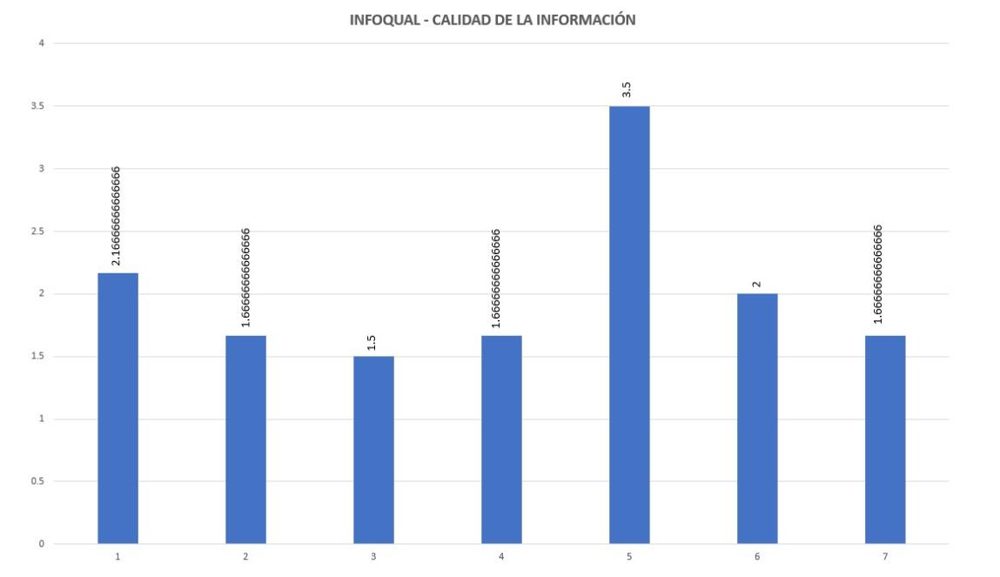
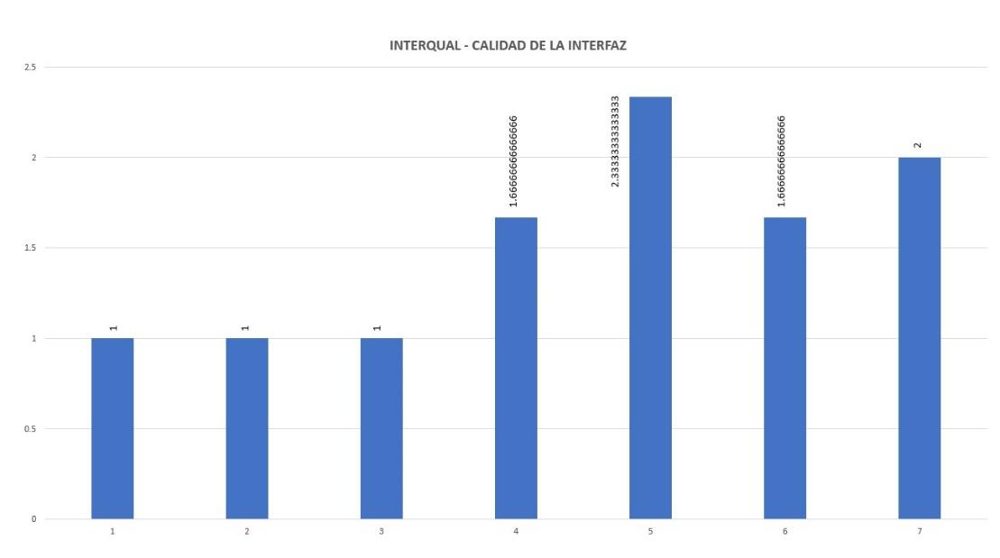
- PSSUQ — cuestionario de satisfacción de 16 ítems en escala Likert de 7 puntos, desglosado en tres subescalas: utilidad del sistema (SYSUSE), calidad de la información (INFOQUAL) y calidad de la interfaz (INTERQUAL).
- PURE — calificación experta que puntúa cada paso de 1 (muy fácil) a 3 (muy difícil o imposible), permitiendo comparar contra las métricas de la prueba con usuarios.
Los hallazgos
El hallazgo principal: la tarea de activar el GPS antes de abrir la app tuvo 0% de completitud en los tres grupos — con una sola excepción. Prácticamente todos los usuarios la omitieron, y la aplicación tuvo que solicitarles activarlo después para poder funcionar.
Este dato es más interesante de lo que parece. Todas las demás tareas se completaron al 100%, muchas en menos de 10 segundos. La falla no estaba en la app, sino en una suposición del diseño: esperar que el usuario prepare el dispositivo antes de usar el producto. Nadie lo hace. El sistema de recuperación funcionó — pero el flujo ideal nunca ocurrió.
Fricción por fragmentación de dispositivos
La prueba con dispositivos reales reveló problemas que un entorno controlado habría ocultado: a un usuario con Xiaomi el sistema le exigió un análisis de seguridad que retrasó la instalación; otro participante no recibió el código de registro en el primer intento y tuvo que solicitarlo de nuevo, llegándole finalmente por WhatsApp.
El problema estructural: el botón de cancelar
Tanto las entrevistas con participantes como la evaluación heurística independiente coincidieron en un mismo punto: el botón de cancelar permanece disponible incluso después de que el viaje fue aceptado y ya está en curso, con el pasajero dentro de la unidad.
Esto afecta directamente a los conductores, que pueden perder un viaje en cualquier momento del trayecto. A pesar de haber sido señalado por usuarios y expertos, el sistema no ha sido modificado — un recordatorio de que identificar un problema de usabilidad y lograr que se corrija son cosas distintas.
Aprendizajes
Triangular tres instrumentos fue determinante: el desempeño mostró dónde fallaban los usuarios, el PSSUQ mostró cómo se sentían al respecto, y las heurísticas explicaron por qué ocurría. Ninguno de los tres, por sí solo, habría dado el panorama completo.
Como moderadora, el aprendizaje más útil fue metodológico: mantener el protocolo idéntico para todos los participantes es lo que permite comparar resultados sin sesgo. Y una limitación honesta del estudio: no evaluamos la experiencia durante el viaje, por lo que no pudimos verificar los problemas reportados sobre cobros y comisiones.